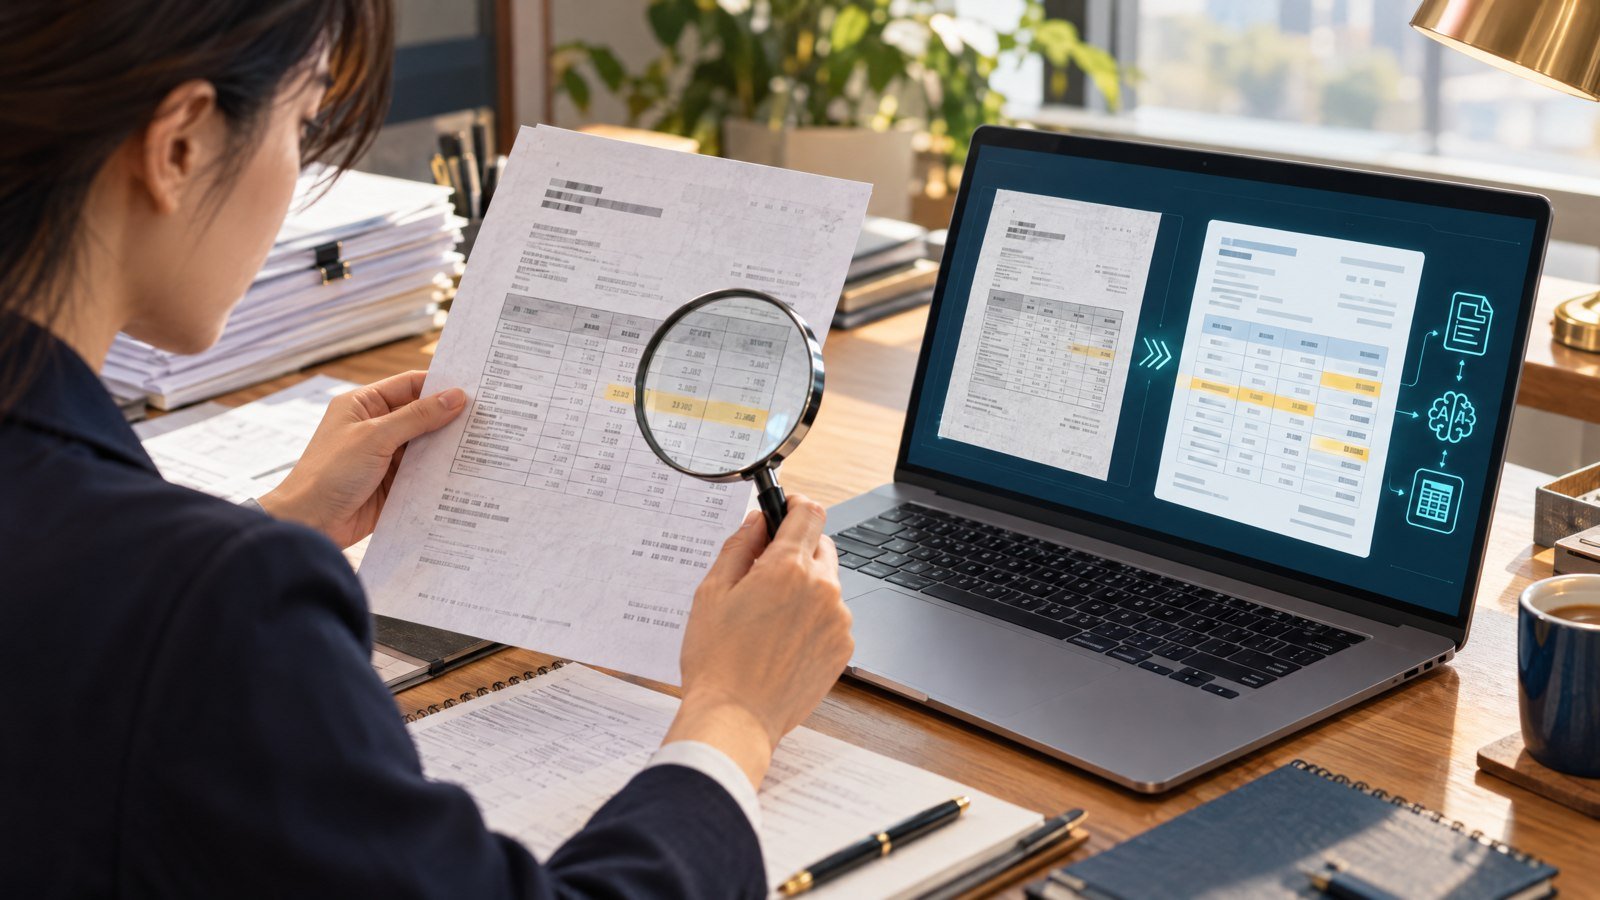
進行 AI OCR 驗收時,把掃描 PDF 送進 OCR,得到可搜尋的文字只是起點。真正的驗收,要確認文字沒有悄悄變形、閱讀順序合理、表格仍能使用,並為疑似錯誤保留人工把關。以下用五個查核重點,協助團隊判斷「能不能上線」,而不是被一個漂亮的分數說服。
先釐清:confidence 不是正確率保證
Microsoft Azure Document Intelligence 官方說明,confidence 是模型對預測結果的統計信心;欄位信心值介於 0 與 1,並不等於你的整批文件已達同等比例的正確率。文字辨識信心與鍵值欄位抽取信心也是不同層次,不能只看其中一個。Google Document AI 也提供文字、版面與影像品質等訊號,但品質或信心指標仍是分流依據,不是免人工驗證的通行證。
因此,驗收應以「拿真實文件與原稿逐項比對」為核心,將 OCR 信心分數用來排序風險、觸發複核,而不是宣稱 OCR 百分之百正確。
查核一:逐頁核對文字,不只搜尋幾個關鍵字
先建立一份代表性樣本:包含清晰與模糊掃描、不同字體、直式與橫式、印章、手寫、頁首頁尾,以及中英數混排。逐頁對照原 PDF,特別圈出容易出錯的內容:人名、地址、日期、金額、小數點、負號、編號與專有名詞。除了肉眼閱讀,也可用頁數、段落數、文字長度與必要欄位清單做基本完整性檢查。
實際例子:文件編號中的「8」被辨成「B」,全文閱讀看似流暢,卻會讓後續資料匹配失敗。這類錯誤不會因為版面漂亮而消失;應保留原圖座標,讓覆核者能快速跳回該字。
查核二:檢查閱讀順序與版面結構
OCR 文件辨識的輸出不是單純一串字。Microsoft 的 Layout 文件列出頁面、段落、行、字、標題角色、頁首頁尾、選取標記、表格與圖形等結構;Google Document AI Enterprise OCR 也可辨識區塊、段落、行、字和符號。驗收時要把輸出還原成「人讀得懂」的順序:雙欄文章是否左右欄交錯?註腳是否跑到正文前?頁碼、浮水印、頁首頁尾是否被誤當成內容?旋轉頁是否方向正確?
不要只開純文字檔檢查;同時檢視帶座標的 JSON、HTML 或 Markdown 預覽。座標能幫你判斷一段文字來自哪一頁、哪個區域,也方便人工回查。
查核三:把 PDF 表格辨識當成資料結構驗收
表格最容易出現「文字都在,但資料已壞掉」的情況。請逐欄核對欄名、列數、合併儲存格、跨頁接續、行列位置、小數點與負值;再用幾筆加總或欄位規則做合理性檢查。Microsoft 的 Layout 輸出包含列、欄、row span、column span、儲存格座標與欄名判斷;這代表工具能提供結構線索,但仍需要針對你的表格樣式驗收。
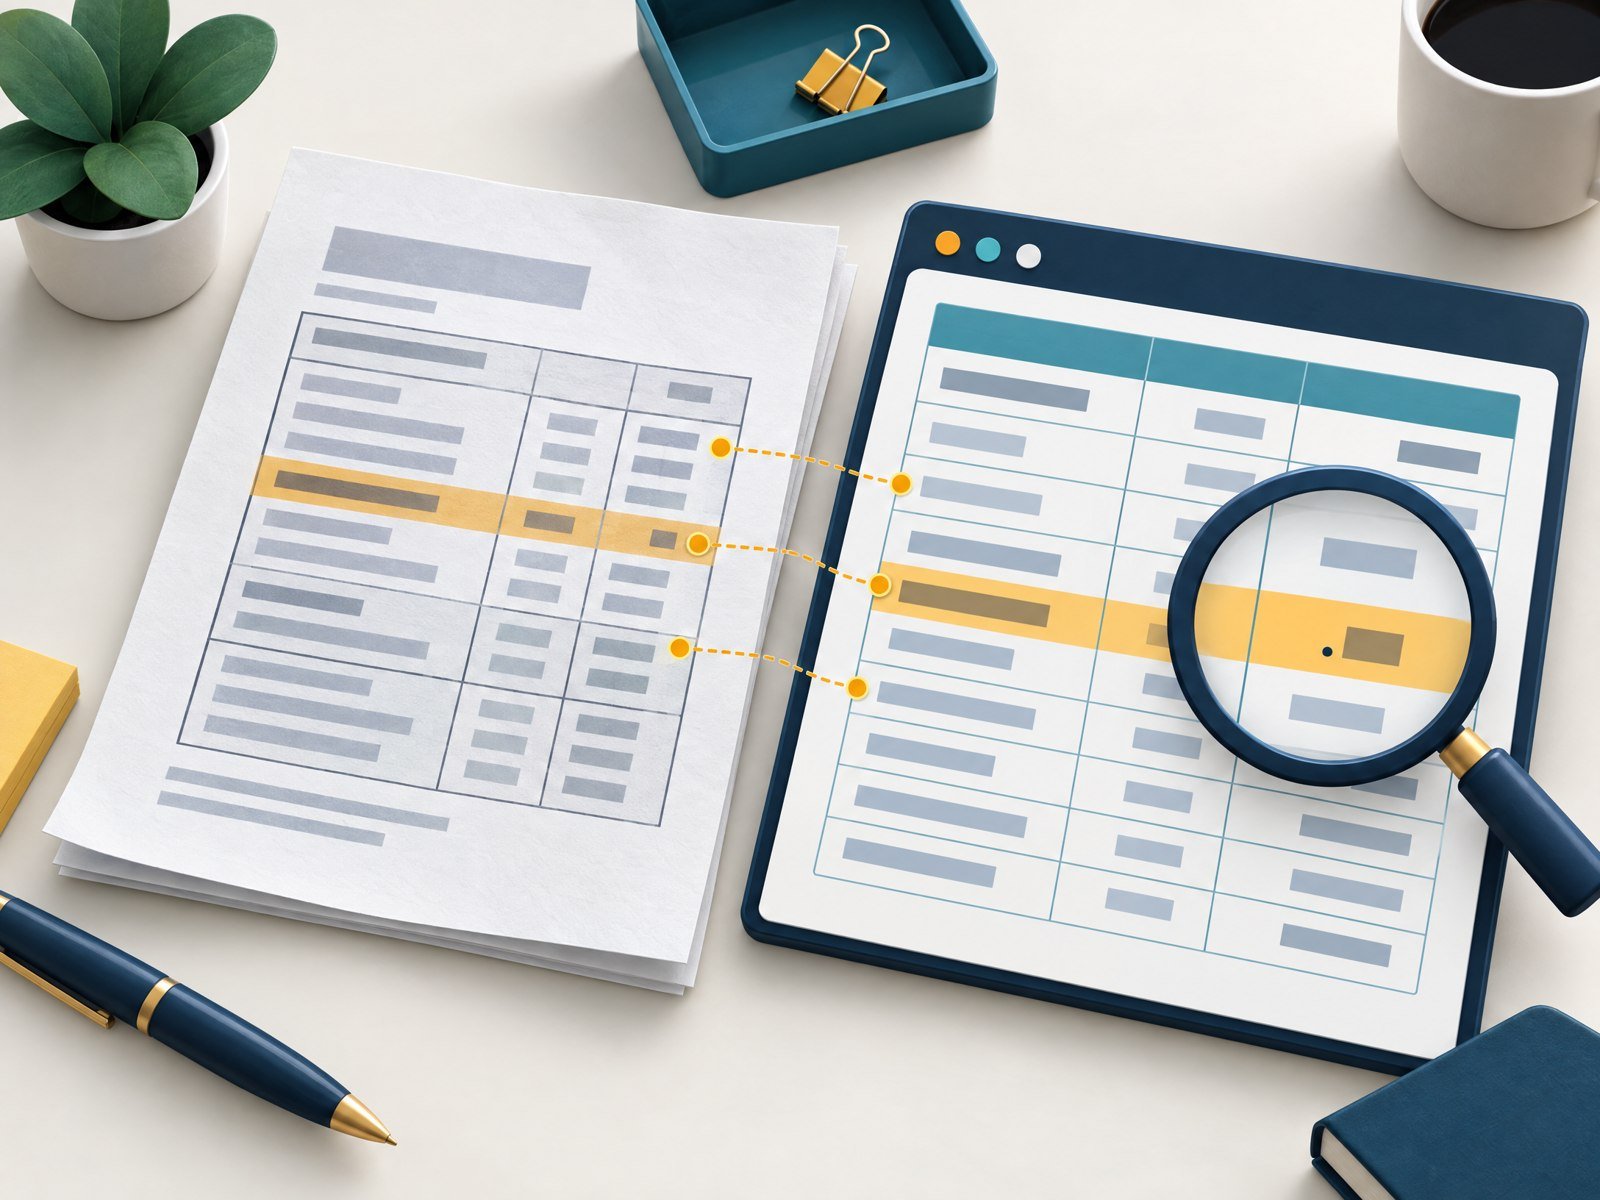
實際例子:一張跨兩頁的費用表,第二頁延續第一頁欄名。若 OCR 將延續列接到錯誤欄位,純文字比對可能看不出來,匯入試算表後卻會造成報表錯算。驗收應將輸出轉成可檢查的列欄資料,抽查首列、中段、跨頁列與總計列。圖像辨識不能保證自動還原所有表格;複雜合併儲存格、手寫表格或低畫質掃描,應設計人工處理路徑。
查核四:用抽樣與人工覆核決定是否放行
先按文件類型、頁面品質、語言、欄位重要性與信心值分層,再從每層抽樣,記錄「字錯、漏字、錯序、表格錯欄、頁面遺漏」等錯誤,而非只算一個總分。對付款、合約、身分或醫療資料等高風險內容,低信心欄位應直接進人工覆核;即使分數高,也要保留定期抽樣,因為模型可能對一整類版型的錯誤過度自信。
Azure 官方建議在準確性關鍵的情境用信心值決定自動接受或轉人工,也提醒不同格式(例如數位 PDF 與掃描 PDF)會影響模型表現。Google 文件則提供影像品質訊號,可用於把模糊、裁切、反光或字太小的頁面先分流。驗收紀錄應包含原檔、OCR 版本、輸出、抽樣結果、覆核人與修正時間,讓日後能追溯。
查核五:確認資料隱私、保存與刪除邏輯
文件通過辨識,不代表可以任意長期保存。盤點原始 PDF、頁面影像、抽出的文字、JSON、日誌、快取與人工修正版各自存在哪裡、保存多久、誰能讀取,並確認傳送區域、加密、權限、供應商條款與適用法規。Azure 的負責任 AI 文件提醒,含個人資料的方案要有合法且正當的用途,並依應用目的制定原始文件與抽出文字的保存政策;敏感或高風險流程應保留人工監督。這些是治理要求,不是 OCR 分數能替你決定的事。
上線前檢查清單
- 樣本涵蓋實際版型、語言、畫質、方向與關鍵文件類型。
- 每頁可回到原圖;頁數、文字完整性與關鍵欄位已核對。
- 雙欄、標題、頁首頁尾、註腳、旋轉頁的閱讀順序正確。
- 表格的欄列、合併儲存格、跨頁、總計與數值規則已抽查。
- confidence 只作風險分流;低信心與高風險內容有人工覆核。
- 有抽樣紀錄、錯誤分類、版本追蹤與回歸測試,而非一次性目測。
- 原檔、輸出、日誌與修正版的存取、保存及刪除政策已確認。
結語:驗收的是流程,不是一個數字
可靠的 AI OCR 驗收,必須同時看文字、結構、表格、人工流程與資料治理。信心分數可以幫你排隊,但不能代替原稿比對;版面模型可以輸出座標和表格線索,也不保證任何複雜表格都能自動復原。先用真實樣本建立基準,再以抽樣和人工覆核持續監測,才是掃描 PDF 轉文字後可放心交付的做法。