有些大型語言模型的總參數數量非常驚人,但資料表又會列出「每個 token 啟用的參數」遠少於總參數。這不是前後矛盾,而是混合專家模型(Mixture of Experts,MoE)常見的設計:模型裡準備多個專家子網路,每個 token 經由路由器選用其中一小部分。
先記住兩個數字代表不同事情:總參數近似模型整體可用的權重規模;活躍參數則描述一次處理 token 時實際參與計算的部分。活躍參數較少,不代表模型就能像同等大小的密集模型一樣直接塞進較小的 GPU,也不保證回覆一定更快。
MoE 不是一群聊天機器人,而是模型裡的路由架構
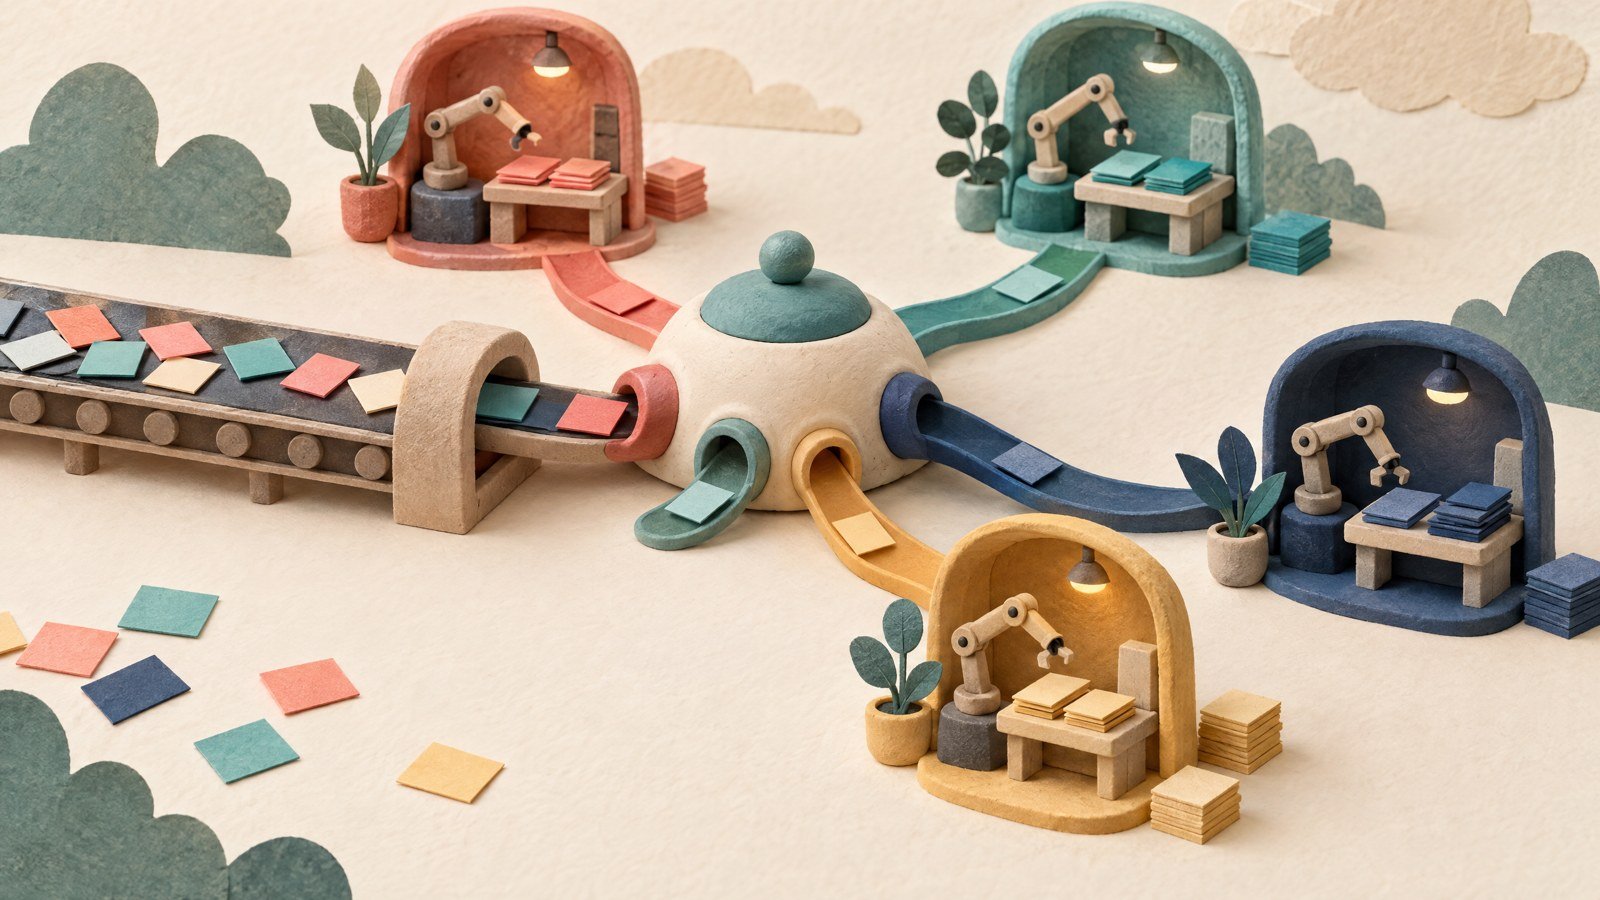
在 Transformer 中,MoE 通常把部分密集的前饋網路(Feed-Forward Network,FFN)換成多個「專家」子網路,再加上一個學習而來的路由器(router)。路由器看每個 token 的內部表示,選擇要送去哪幾個專家;有些模型採用 top-1,有些採用 top-k,架構各有不同。
這些「專家」不是預先貼好「數學專家」「法律專家」標籤的獨立聊天機器人。它們是模型內部可訓練的子網路;路由行為是在訓練中學得,不應只憑名稱推論某個專家負責哪一種人類主題。Hugging Face 的 MoE in Transformers 介紹也特別提醒:expert 並非必然對應清楚可解讀的主題專長。
密集模型與稀疏 MoE:每個 token 用到的計算不同
- 密集模型:在相關網路層中,每個 token 通常經過同一套完整計算。
- 稀疏 MoE:每個 token 只送往被路由器選中的少數專家;其他共享部分,例如注意力層,仍照常運作。
因此,MoE 可以把更多專家權重放進同一個模型,並讓單一 token 只經過部分專家計算。這會改變計算量與模型容量的取捨,但不是所有參數都消失了,也不是所有 MoE 都用相同的路由規則。NVIDIA 對 LLM 架構中 MoE 的說明指出,路由策略要在模型表現、專家負載與通訊效率間取捨。
看懂「總參數」和「每 token 啟用參數」
以 DeepSeek-V3 技術報告為例,作者列出模型共有 671B(6710 億)總參數,其中每個 token 啟用約 37B(370 億)參數。這能幫助讀者理解「總容量」與「單 token 計算路徑」的差異;它不表示模型只需要 37B 權重的儲存空間,也不表示速度或品質等同一個 37B 密集模型。完整數字與架構以 DeepSeek-V3 Technical Report 為準。
推論服務仍需要讓各專家權重可被執行環境取得;它們可能分散在多張 GPU、做量化,或透過其他執行方式管理,但單看活躍參數不能推得顯存需求。真正的部署預算還要看權重格式、硬體配置、批次、其他中間張量與 KV Cache 等項目。
路由帶來效率,也可能帶來新的瓶頸
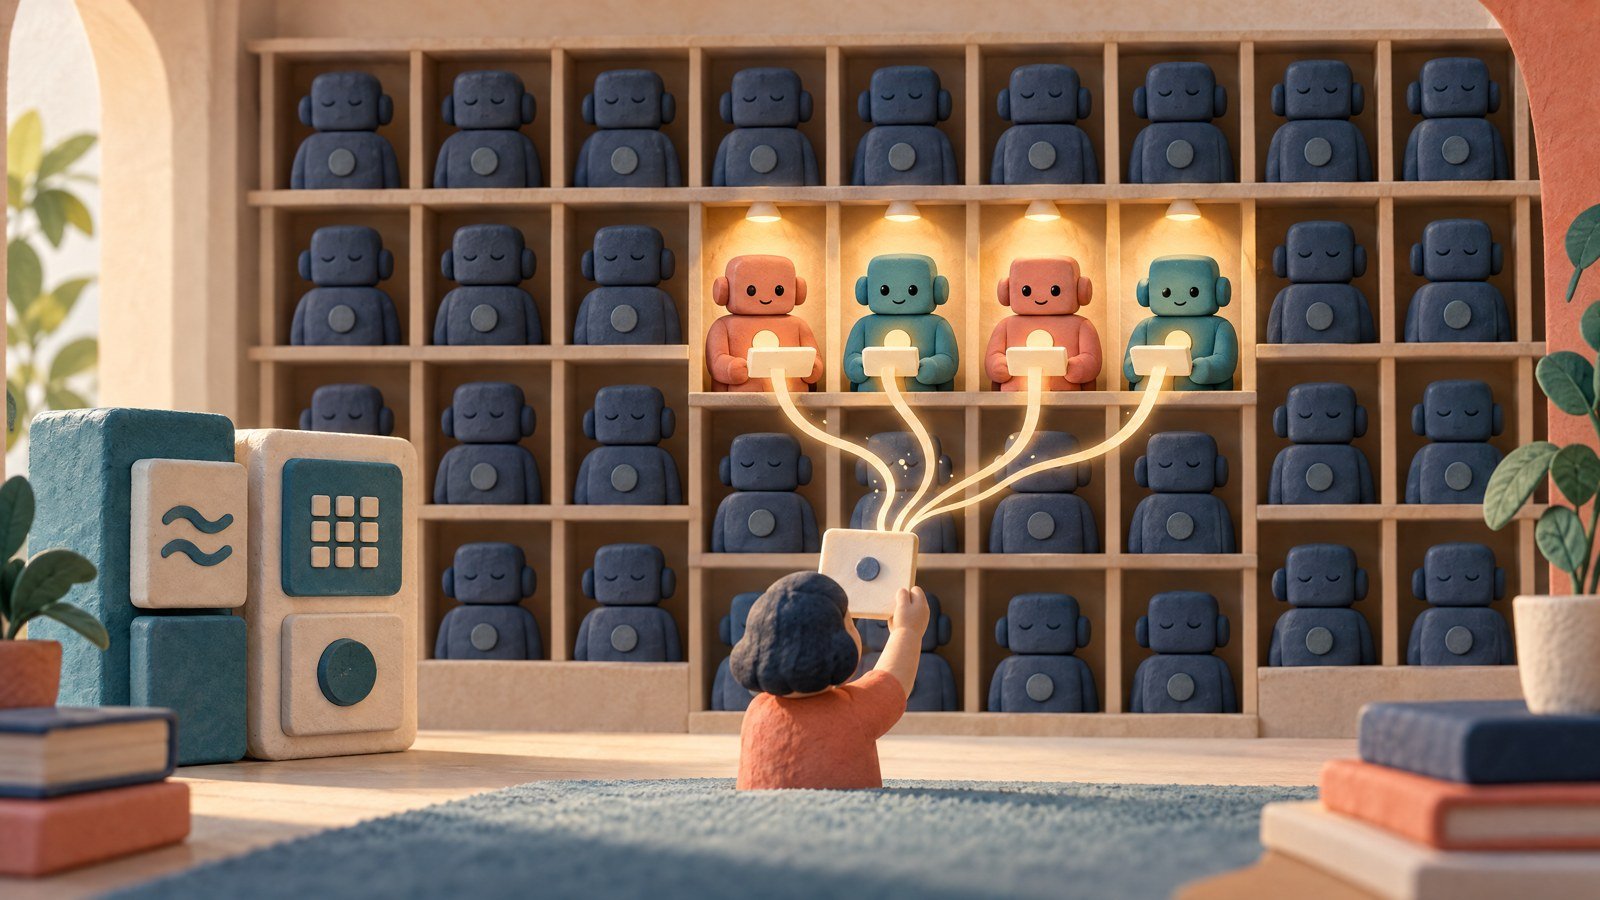
若很多 token 同時被送到少數熱門專家,其他專家卻閒置,就會出現負載不平衡。大規模執行時,專家也可能分布在不同裝置上;token 必須送到專家所在位置,再把結果收回,因此網路通訊、排程、批次大小和專家分布都會影響實際延遲與吞吐。降低每 token 的理論計算量,不等於每個工作負載都能得到更低的端到端延遲。
訓練和推論也要分開看。訓練階段可能使用負載平衡損失、容量設定等方法,減少路由集中造成的效率問題;不同架構對超量 token 的處理方式不盡相同。Hugging Face 的 MoE Explained說明,專家容量、token 分派和裝置間通訊會形成實際取捨,不能只拿專家數量推斷速度。
挑選或部署 MoE 模型前,先看這 5 件事
- 分清參數欄位:查清楚總參數、每 token 活躍參數、專家數量與每次啟用幾位專家,別把不同數字當成同一種模型大小。
- 檢查模型權重需求:查看模型卡和推論框架支援的權重格式、量化方式、裝置分配及記憶體估算;活躍參數不能直接當成下載大小或 VRAM 需求。
- 看實測而非只看 FLOPs:在自己的 GPU、提示長度、批次和併發下測首 token 等待、生成速度及吞吐。
- 留意多裝置通訊:若模型需要跨 GPU 放置專家,網路連線和專家平衡會影響效率。
- 用目標任務評估品質:專家選擇方式與訓練資料都會影響輸出;參數總數或 MoE 標籤不是品質保證。
常見問題 FAQ
MoE 模型的「活躍參數」就是需要下載的大小嗎?
不是。活躍參數描述特定 token 經過哪些子網路;模型檔案還包含未在該 token 上啟用的專家權重與共享部分。實際下載、載入與裝置記憶體需求,需看權重格式、量化和執行方式。
專家會各自學會一門學科嗎?
不一定。專家是透過訓練學到的子網路,路由器依 token 表示分派。即使某些輸入呈現不同路由模式,也不代表每個專家都能簡單解釋成一個明確的人類領域。
MoE 一定比密集模型快嗎?
不一定。只用部分專家可降低某些計算,但端到端速度還受權重讀取、專家分布、裝置間通訊、路由負載、批次和推論核心實作影響。應以實際模型與硬體測試。
結語:MoE 是容量與計算的折衷,不是免費加速
MoE 的關鍵是「整體有許多專家,但每個 token 只走其中一部分路徑」。理解總參數與活躍參數的差別,才能避免把計算量誤當成模型儲存需求;接著再查部署硬體、路由和通訊表現,才能判斷它是否適合自己的工作負載。