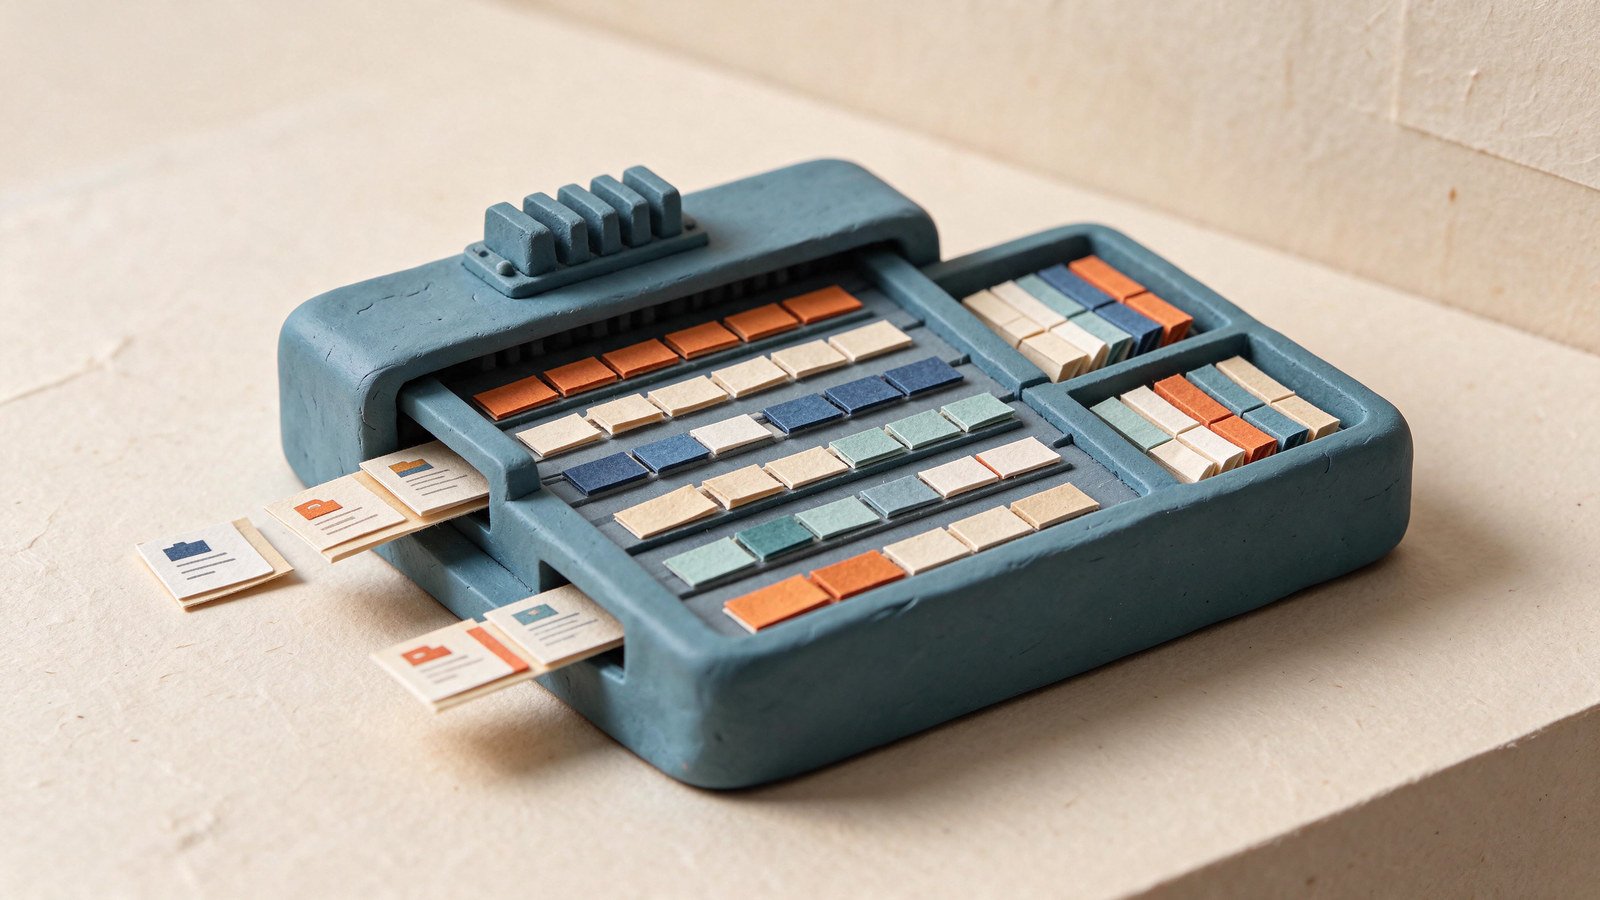
當一個 AI 服務同時收到很多提問,GPU 忙不忙,還取決於系統如何安排每一輪生成。若固定把一批請求綁在一起,短回答先完成後可能空等長回答;新請求也得等整批結束才進場。Continuous Batching(連續批次處理)會在生成過程中動態調整批次,讓完成的請求離開,候補請求有機會接手空出的運算位置。
為什麼固定批次會浪費運算?
大型語言模型通常以自回歸方式逐 token 生成答案。把多個請求放進同一批一起運算,可以提高平行處理效率;但每個人的提示長度、回答長度不同,完成時間也不一樣。固定批次若要等最慢的請求全部結束才換下一批,先完成的項目就會留下空位,剛到達的請求則繼續排隊。
這也是 LLM 服務和一次性處理大量資料不太一樣的地方:互動式推論中的每個請求會持續生成多輪 token,工作長短不一,而且使用者通常希望回覆能開始得快、串流也不要忽快忽慢。
Continuous Batching 如何動態換入請求?
可以把它想成一條不必等全班同學一起下課的工作線:每完成一輪模型運算,排程器就能檢查哪些請求已結束、哪些還在生成,以及佇列裡是否有新請求可加入。完成的請求移出後,新工作便能補上空位;其他仍在進行的請求不必重新等待整批結束。
這種思路和傳統「整個請求批次執行完才重新排隊」不同。USENIX OSDI 論文 Orca: A Distributed Serving System for Transformer-Based Generative Models提出以模型迭代(iteration)為單位的排程,讓請求能在生成過程中動態加入或退出。Hugging Face 的Continuous Batching 技術解說則從提示長短不一、固定批次的 padding 浪費,以及動態排程等角度,逐步說明這類方法的直覺。
長提示詞也會和生成中的請求搶資源
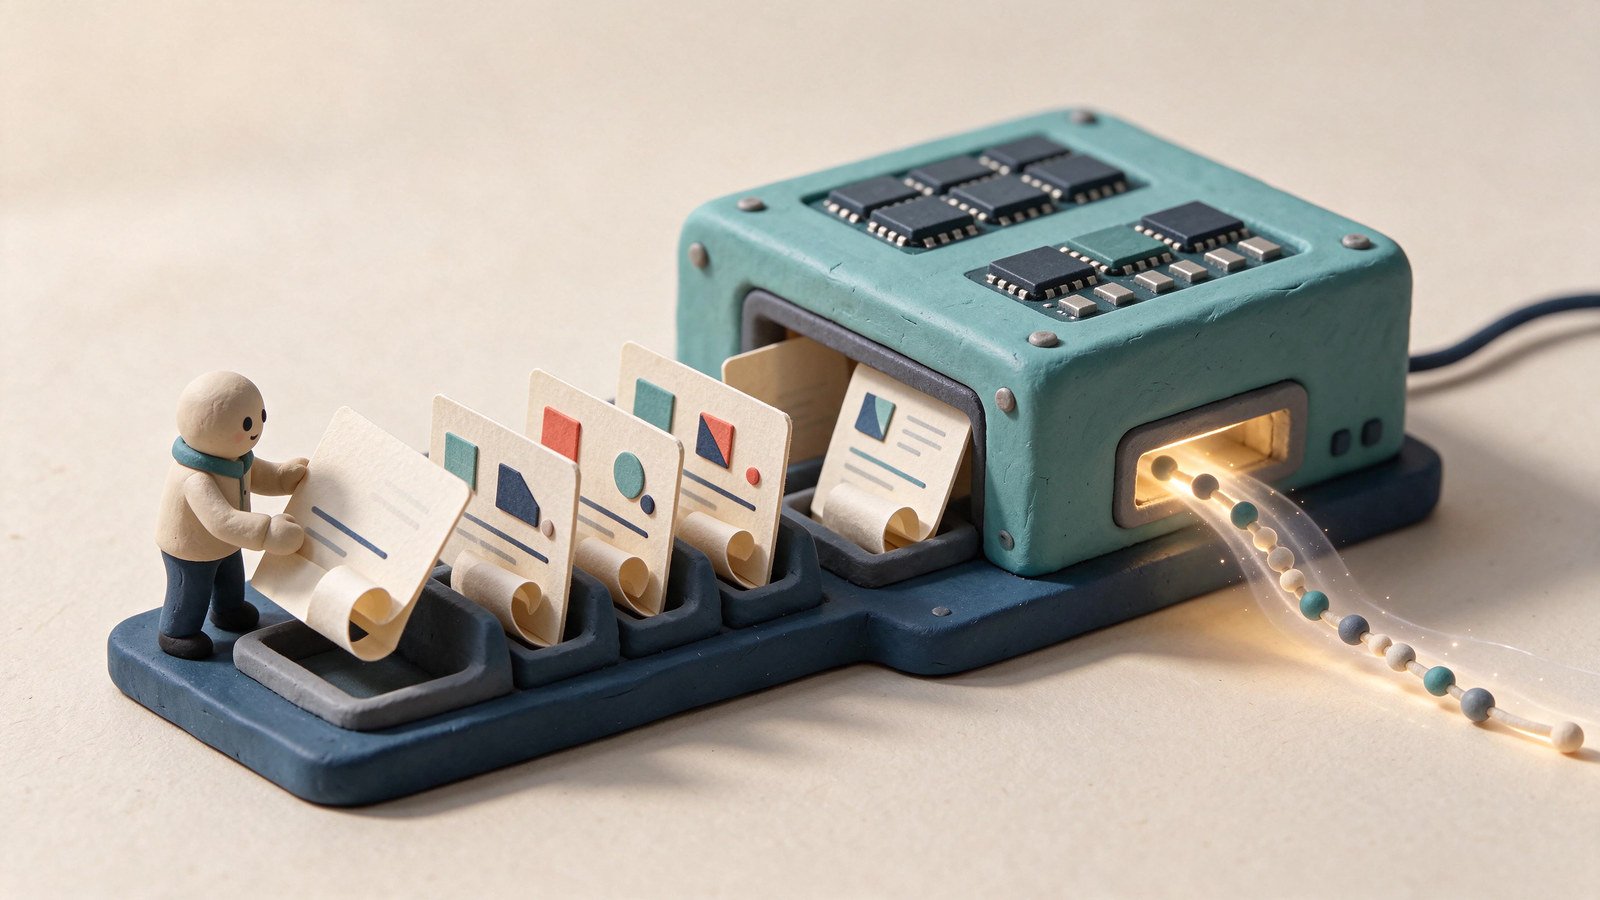
新請求剛進來時,模型得先處理輸入提示,這個階段常稱為 prefill;之後才逐步生成輸出 token,也就是 decode。長提示詞的 prefill 可能佔用較多運算,讓正在等待下一個 token 的請求感到延遲。因此,好的排程不只是盡量塞滿 GPU,也要拿捏新工作開始速度與既有回覆順暢度。
一種做法是把長提示詞分成較小區塊處理,並與生成中的請求一起排程。以 vLLM 官方最佳化文件為例,chunked prefill 會將大型 prefill 切小,再與 decode 請求同批處理;文件也說明,調整每批 token 預算會影響首 token 等待與 token 間延遲的取捨。這是特定推論框架的設定說明,不是所有服務都採用完全相同的排程器或預設值。
它和 Batch API 不是同一種「批次」
Continuous Batching 是線上模型服務端的排程方式:請求通常正在等待互動式回覆,服務端在生成期間調整哪些工作同時使用模型。相對地,Batch API是把許多獨立請求交給非同步工作,稍後再查詢或取回結果,適合可以等待的大量離線任務。兩者目的與時效需求不同,名稱都有「批次」不代表能互相替代。
效率提升有上限,容量仍受記憶體約束
Continuous Batching 能減少固定批次等待帶來的空檔,但不會讓 GPU 的運算能力變無限,也不保證每一種流量下都同時降低等待、提高吞吐。新請求增加時,服務仍可能受模型運算能力、佇列長度、提示長度或 GPU 記憶體限制。每條進行中的生成序列都需要保存運行狀態;其中 KV Cache 如何隨序列數與 token 數影響顯存,可參考站內的 KV Cache 與推論記憶體介紹。
特別要注意的是,平均吞吐變好,不代表每個使用者都會更快拿到第一個 token。熱門服務可能同時追求更多請求完成量與穩定的互動體驗;因此,不能只看一個「每秒 token 數」就下結論。
怎麼測試 Continuous Batching 是否適合?
- 先固定比較條件:使用相同模型、硬體、提示集合、回答上限和抽樣設定,避免把模型或輸出長度差異誤認成排程效果。
- 模擬真實流量:包含請求到達速度、同時對話數、長短提示比例及回答長短,不要只測整齊且固定長度的範例。
- 同時看不同延遲:記錄首 token 等待時間、生成 token 之間的間隔,以及整段回覆完成時間;也要看佇列等待與延遲較高的請求。
- 一起觀察服務容量:比較每秒完成的請求數或輸出 token 數、GPU 使用率、顯存高峰和錯誤率,並確認負載升高時仍有足夠資源空間。
- 調整後再重測:不同推論框架的 token 預算、chunked prefill 與排程策略各有差異,先查當前版本文件,再用自己的工作負載找平衡點。
常見問題
Continuous Batching 會讓模型一次產生很多 token 嗎?
它主要改變多個請求如何共同使用模型與 GPU,不等於每個請求都改成一次產生整段答案。對單一回答的生成方式,仍取決於模型與解碼設定。
開啟 Continuous Batching 就一定更快嗎?
不一定。它的價值通常要在有多個同時或持續到達的請求時,才比較能看出排程利用率的差異;若工作量很少、提示特別長,或顯存已是瓶頸,仍須以實際指標確認結果。
它會改變回答內容或答案品質嗎?
批次排程本身不是提升模型知識或查證能力的功能。回答內容仍受模型、提示、資料與生成設定影響;測試時應將模型與解碼條件固定,再比較服務速度和容量。
重點:在請求之間動態安排運算,不是讓運算憑空增加
Continuous Batching 的核心,是在生成過程中重新安排正在執行的請求,減少固定批次因完成時間不同而留下的空位。它適合需要同時服務多個互動式 LLM 請求的推論系統,但仍要平衡提示處理、token 延遲、佇列和記憶體。準備自己的流量樣本,並同時觀察吞吐與使用者等待時間,才知道動態排程是否真的有幫助。