大型語言模型通常一次預測下一個 token,再把新 token 放回上下文,逐步生成後續內容。這種「一步接一步」的流程,即使模型回答品質很好,也可能讓長答案等得比較久。AI 推測解碼(speculative decoding)的做法很像先請助手草擬幾個字,再讓主要模型一次核對一小段:猜對的候選可以直接保留,碰到不吻合的地方就回到主要模型的正常生成流程。
這項方法有機會減少主要模型必須逐 token 執行的次數,但它不是每個模型和工作負載都會更快的開關。要先看草稿有多少被接受、驗證成本多高,以及服務流量和硬體是否適合。
一、Speculative decoding 怎麼運作?
標準草稿模型方法會由較小的助手模型(draft model)先提議一段候選 token;較大的目標模型(target model)再利用一次前向運算檢查候選。符合目標模型接受規則的部分會進入輸出;未通過的部分則由目標模型依原本流程取代或重新抽樣。實際採用幾個候選、如何判定與重抽,會依解碼演算法和軟體實作而異。
Hugging Face Transformers 的 assisted decoding 文件將它描述為助手提出候選、主模型一次驗證;若候選被拒絕,便回到目標模型的標準抽樣步驟。這個設計試圖減少昂貴的連續模型呼叫,而不是讓小模型取代大模型的最後判斷。
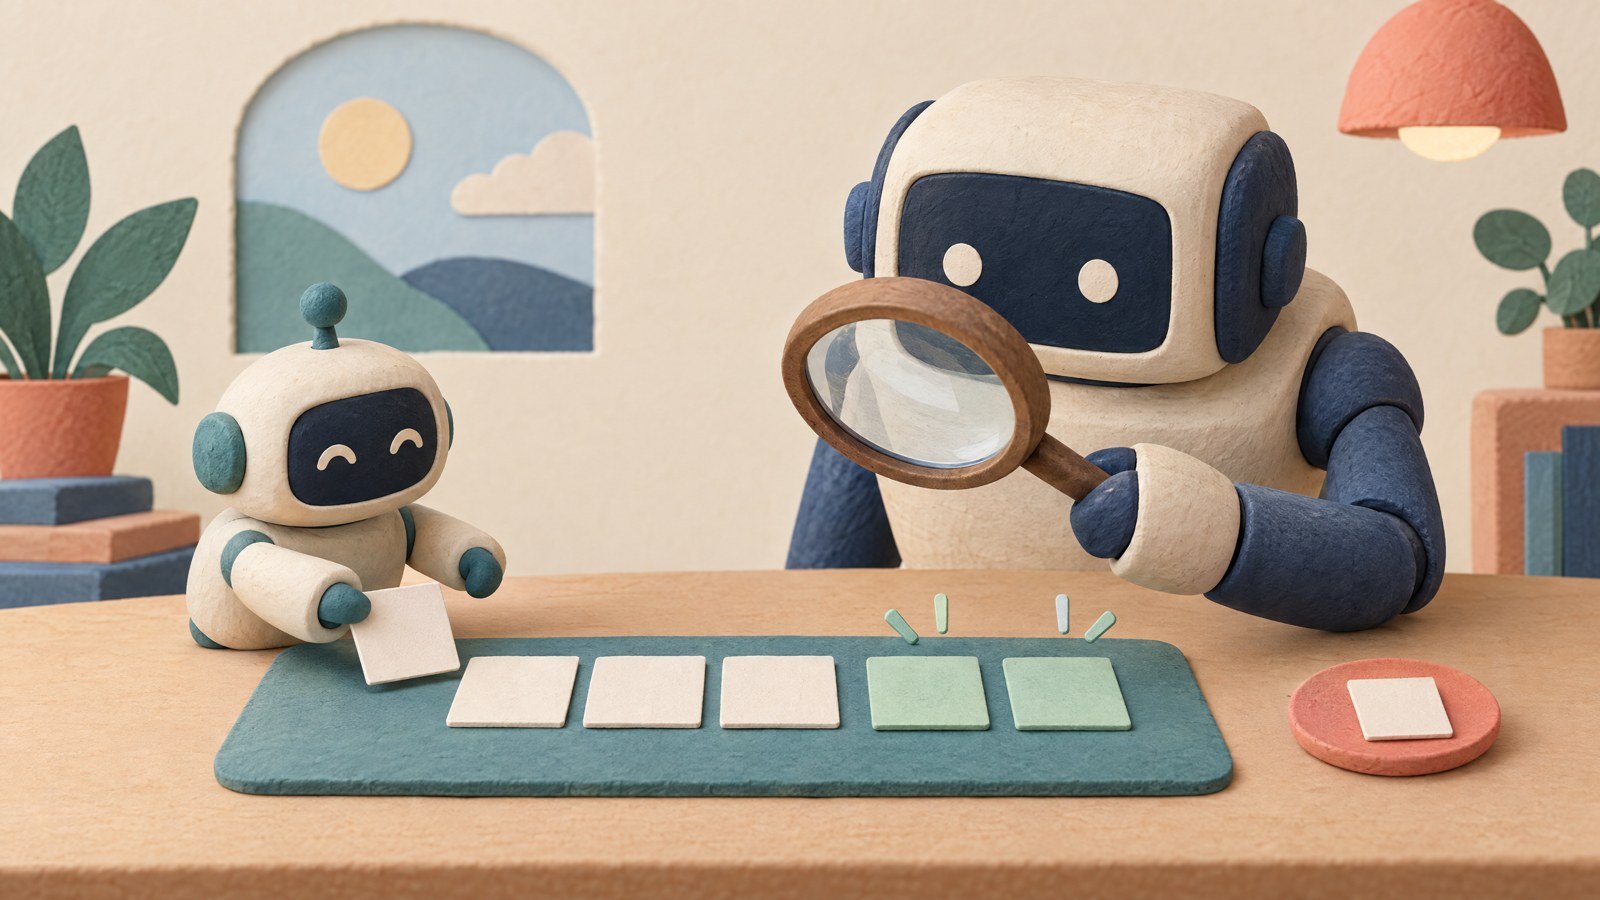
可以用「助理先打草稿、編輯逐段核對」來理解,但不要把它想成助理答案直接照單全收。候選越常吻合,主要模型就越可能一次確認較多 token;如果常常不吻合,額外的草稿和核對未必帶來好處。
二、它會改變答案品質或模型能力嗎?
在標準的無損推測抽樣演算法下,目標是保留原目標模型的輸出機率分布;這不代表每次生成的字句會固定,也不代表所有標為 speculative 的變體都採用相同驗證方式。vLLM 官方文件指出,其標準 rejection sampler 的理論保證受硬體浮點數精度限制;文件也特別指出 FLy 是刻意放寬驗證、並非保留原分布的作法。
因此,看到「無損」時要確認談的是哪種演算法與設定,而不是把某個標準方法的理論性質套到所有推測解碼實作。無損也不等於更聰明、事實正確或安全;回答內容的能力仍由目標模型和提示等因素決定。
推測解碼也不是模型量化。量化改變權重的數值表示,推測解碼改變生成時如何安排候選與驗證。你可以先讀站內的4-bit、8-bit 量化與記憶體需求,分清兩種各自解決的問題。
三、哪些情況可能受益?
這項方法特別值得在目標模型逐 token 解碼受限、且草稿能經常被接受的條件下測試。Hugging Face 文件說明,傳統助手模型方式通常在助手明顯較小、且與目標模型使用相同 tokenizer 時效果較好。這是該方法的重要選型線索,不是每種變體的硬性規則:同一份文件也介紹 universal assisted generation,可處理不同 tokenizer 的配對方式,但支援能力要看具體實作。
服務型態也會影響結果。vLLM 文件將其使用場景定位為中低請求率、記憶體受限工作負載下,降低 token 與 token 之間的延遲;文件也明確提醒實際收益取決於模型家族、流量、硬體與抽樣設定。若主要痛點不是逐 token 延遲,或同時湧入大量請求,應以自己的服務負載驗證,而不是套用別人的速度數字。
不是每種推測解碼都需要另一個小模型。Hugging Face 也介紹了 prompt lookup decoding:從提示中找重複的 token 片段來提出候選,遇到摘要、翻譯等以輸入內容為主的任務時可能值得測試;找不到相似片段就退回一般生成。另有自我推測解碼等方法,但可能只適用於經特別訓練或支援特定結構的模型。
四、上線或試用前,先做這些比較
- 確認實作支援:查目標模型、草稿模型、tokenizer、推理框架與解碼模式的相容條件。相同 tokenizer 是傳統助手方式的重要條件;新型跨詞彙方法需確認框架和版本確實支援。
- 記錄目前基準:先在關閉推測解碼時測量自己的提示、生成長度、抽樣設定與硬體,再只切換推測解碼,避免一次改動多項條件。
- 測真實工作:加入短答、長答、常見格式與實際業務提示。草稿模型對不同題目的吻合程度可能不同,不能只挑最容易連續猜中的示例。
- 看整體服務指標:觀察 token 間延遲、整段完成時間、吞吐量、資源占用與失敗情況;推測解碼主要針對生成階段的連續解碼,不應只憑單一延遲指標判定成敗。
- 同時看草稿接受情況:若框架提供接受長度或接受率等指標,把它們和延遲、吞吐一起看。接受率是診斷線索,不是單獨可代表整體效能的分數。
- 保留回退方案:若草稿常被拒絕,或啟用後整段回覆反而更慢,就比較不同助手或無助手方法,必要時回到基準設定。不要為了展示功能而犧牲已驗證的服務表現。
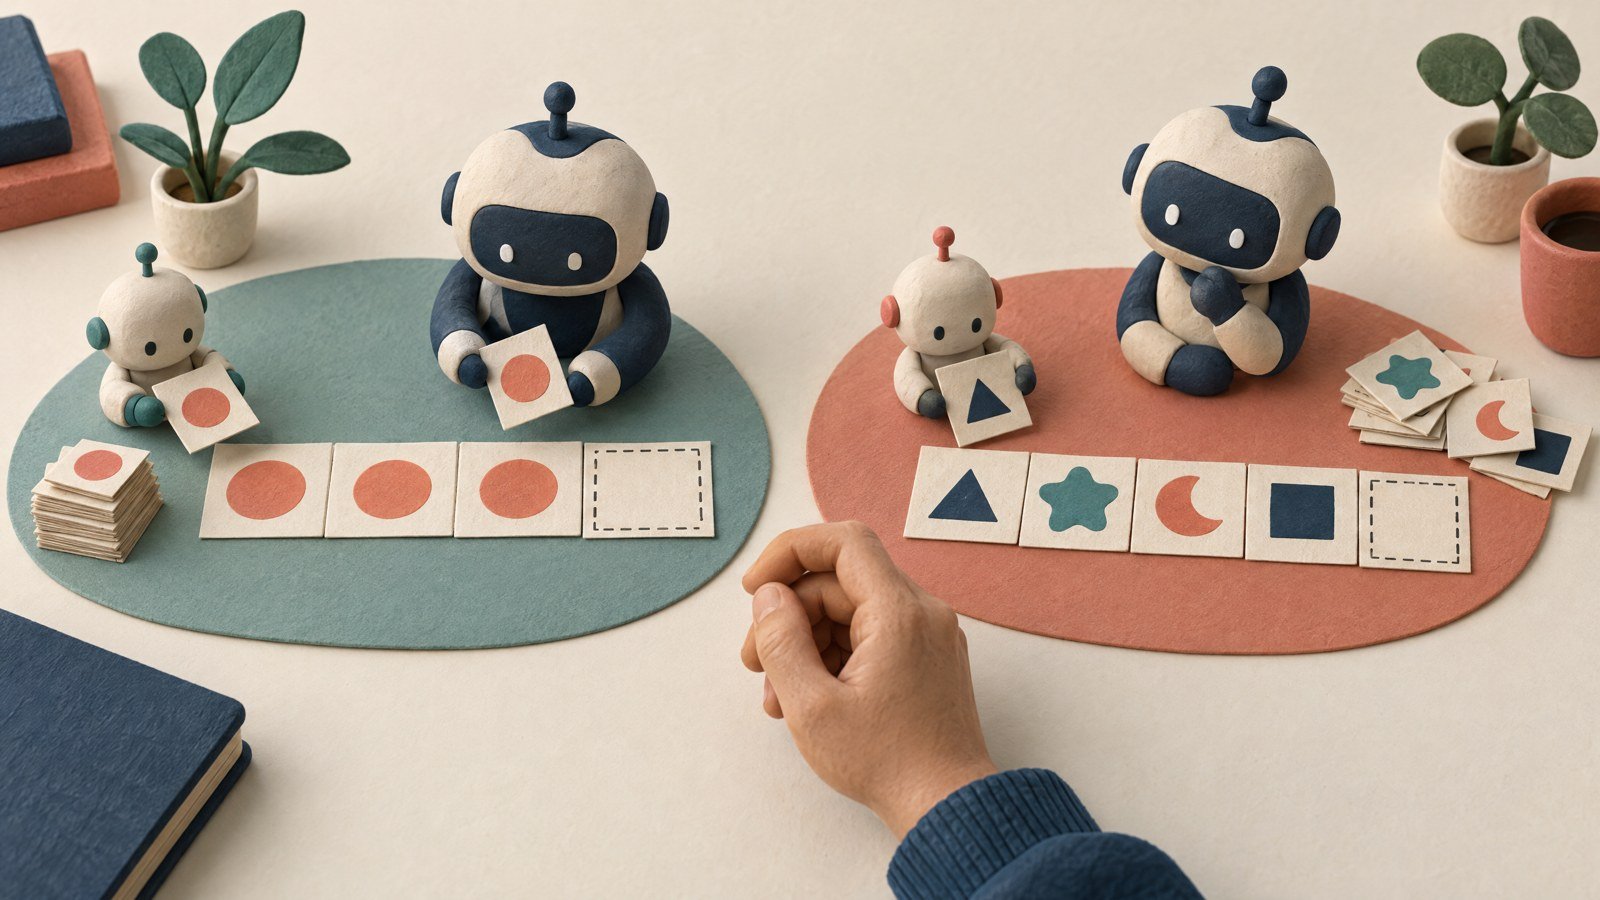
以上是測試方法,不是速度提升承諾。vLLM 文件也建議在自己的環境做可重現的量測;不同模型、硬體、流量和提示即使使用相同框架,也可能有不同結果。
常見問題 FAQ
草稿模型猜錯時,錯的文字會直接留在答案裡嗎?
標準推測解碼會由目標模型驗證候選,未通過的部分依驗證演算法替換或重新抽樣;不是把助手草稿不經檢查直接交給使用者。實際行為仍要核對所用框架的具體解碼方式。
所有小模型都能當助手模型嗎?
不一定。除了模型與 tokenizer 的相容性,還要看推理框架支援的配對和生成方式。傳統 Transformers 助手解碼文件建議助手模型明顯小於目標模型、並使用相同 tokenizer;其他方法可能有不同限制。
開啟推測解碼,一定會縮短使用者等待時間嗎?
不一定。候選被接受的情形、草稿與驗證成本、硬體和請求流量都會影響結果。應用同一組實際任務與服務設定,對照啟用前後的 token 間延遲、完成時間、吞吐和資源用量。
結語:讓目標模型核對「猜得值不值得」
AI 推測解碼不是讓小模型取代大模型,而是先提出候選,再讓目標模型驗證,以期減少連續解碼的成本。它是否適合,要看候選能否常被接受、軟體是否支援,以及真實流量下的總體表現。先建立基準、用自己的任務比較,再決定是否啟用,比追逐單一速度數字更可靠。